こんにちは!Kredo Blog編集部のさおりです!
CSVを読もうとしたら、日本語が崩れたり、UnicodeDecodeErrorで止まったり。検索して見つけたencodingを次々に試すうちに、何が正しいのか分からなくなることがあります。
まず確かめたいのは、CSVを保存した文字コードと、Pythonが読み取るときの文字コードが合っているかです。この記事では、同じ3件のデータをUTF-8・BOM付きUTF-8・CP932で用意しました。読み取り、BOMの確認、別名への変換を、実行結果と比べながら練習してみましょう。
文字化け・読み込みエラー・列ずれを分ける
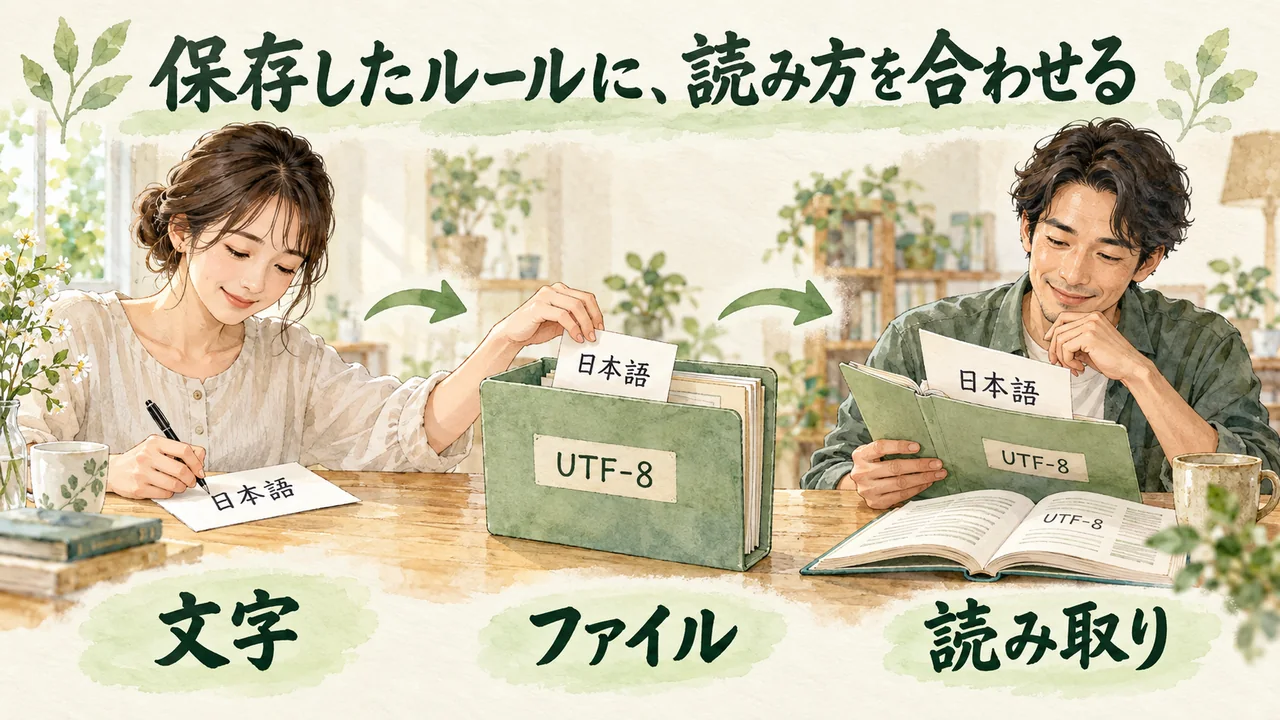
「CSVがうまく読めない」といっても、原因は同じではありません。ファイルの拡張子が.csvでも、文字コードまでは決まりません。
| 見えている問題 | 先に確かめること |
|---|---|
| UnicodeDecodeErrorで止まる | 指定した文字コードが実際のファイルと合うか。途中で壊れたデータでないか。 |
| 読めたが、日本語が別の文字に見える | エラーなしでも正しいとは限らない。出力元の設定と、正しい表記を照合する。 |
| 最初の列名だけ一致しない | BOM、空白、全角・半角など、見えにくい差をreprで調べる。 |
| 文字は正しいが、列がずれる | 区切り文字、引用符、値の中の改行を確認する。 |
文字コードは、文字をバイト列として保存したり、バイト列を文字へ戻したりするためのルールです。カンマや引用符による列ずれとは、分けて考えます。列ずれが中心なら、CSVのカンマ・改行・引用符の読み込み例へ進んでください。
Pythonのcsvモジュールに渡す前に、ファイルを開く処理で文字コードを指定します。CSVをファイルから読むときのnewline=""は、CSVの改行を扱うための指定です。参考:Python公式のcsvドキュメント
同じ3行を、3種類の文字コードで読み比べる
CSV文字コードの練習教材をダウンロードする(ZIP)を、専用の練習フォルダーへ展開してください。CSV3点、Pythonコード5点、実行結果、READMEが入っています。標準ライブラリだけを使うので、追加のパッケージは必要ありません。
CSVの中身は、次の架空の商品データです。データ件数は3件、数量の合計は9と、先に答えを決めておきます。
商品,数量
りんご,2
みかん,3
バナナ,4| 教材ファイル | 保存した文字コード | 今回使うencoding |
|---|---|---|
| sample_utf8.csv | UTF-8、BOMなし | utf-8 |
| sample_utf8_bom.csv | UTF-8、BOMあり | utf-8-sig |
| sample_cp932.csv | CP932 | cp932 |
01_read_three.pyには、ファイルごとに確認済みの文字コードを指定しています。ファイル名から自動判定しているわけではありません。
from pathlib import Path
import csv

folder = Path(__file__).resolve().parent
samples = [
    ("sample_utf8.csv", "utf-8"),
    ("sample_utf8_bom.csv", "utf-8-sig"),
    ("sample_cp932.csv", "cp932"),
]

for filename, encoding in samples:
    with (folder / filename).open(encoding=encoding, newline="") as f:
        reader = csv.DictReader(f)
        rows = list(reader)
        fields = reader.fieldnames
    total = sum(int(row["数量"]) for row in rows)
    print(filename, fields, len(rows), total)
展開したフォルダーをターミナルで開き、Python 3が使える環境で次を実行します。環境で使っているコマンドがpythonやpyなら、python3の部分を置き換えてください。
python3 01_read_three.py実行結果は、左からファイル名、列名、データ件数、数量の合計です。
sample_utf8.csv ['商品', '数量'] 3 9
sample_utf8_bom.csv ['商品', '数量'] 3 9
sample_cp932.csv ['商品', '数量'] 3 9
この教材では、日本語の列名と数値が同じように読めました。実務のCSVを扱うときは、合計だけでなく、商品名やIDなどの値そのものも確かめます。合計が合っていても、文字が正しいとは限りません。
UTF-8のBOMが列名に残るときの直し方
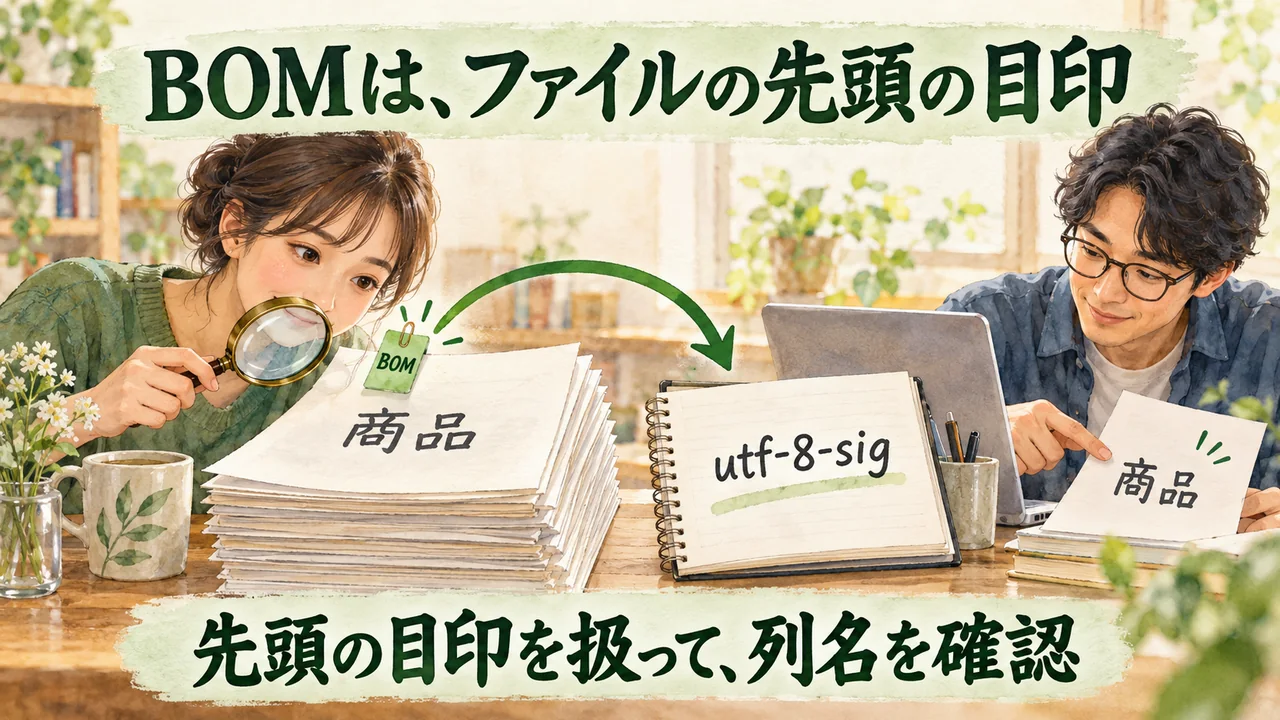
BOMは、この教材ではファイルの先頭に置かれた目印です。BOM付きUTF-8の先頭3バイトは、16進数でef bb bfになります。UTF-8にBOMが必須という意味ではありません。
次のコードは、同じBOM付きファイルを二通りで読みます。repr()は、見えない文字を含む列名の違いを調べるために使っています。
from pathlib import Path
import csv

path = Path(__file__).resolve().parent / "sample_utf8_bom.csv"
print("先頭3バイト:", path.read_bytes()[:3].hex(" "))

for encoding in ["utf-8", "utf-8-sig"]:
    with path.open(encoding=encoding, newline="") as f:
        reader = csv.DictReader(f)
        row = next(reader)
        print(encoding, repr(reader.fieldnames[0]), "商品" in row)
python3 02_check_bom.pyの実行結果:
先頭3バイト: ef bb bf
utf-8 '\ufeff商品' False
utf-8-sig '商品' Trueutf-8で読むと、先頭の列名は'\ufeff商品'です。画面では「商品」に見えても、'商品'とは異なります。これが、row["商品"]でKeyErrorになる原因の一つです。
utf-8-sigで読むと、ファイル先頭のUTF-8 BOMを処理して、列名が'商品'になりました。この教材のBOMなしUTF-8も、utf-8-sigで同じ内容を読み取れることを確認しています。参考:Python公式のutf_8_sig
ただし、utf-8-sigは、あらゆる文字コードを自動で読む指定ではありません。CP932のファイルは、BOMの有無を変えるだけではUTF-8になりません。また、文字列の途中にある文字まで一括削除する必要もありません。
CP932のCSVを、確認した文字コードで読む
教材のsample_cp932.csvを、UTF-8として読んでみます。次のコードでは、わざと指定を変えたときのエラーを捕捉し、その後、正しい指定で読み直しています。
from pathlib import Path
import csv

path = Path(__file__).resolve().parent / "sample_cp932.csv"

try:
    with path.open(encoding="utf-8", newline="") as f:
        rows = list(csv.DictReader(f))
except UnicodeDecodeError as error:
    print(type(error).__name__)
    print("指定した文字コードでは読み取れません。")

with path.open(encoding="cp932", newline="") as f:
    rows = list(csv.DictReader(f))
print([row["商品"] for row in rows])
python3 03_wrong_encoding.pyの実行結果:
UnicodeDecodeError
指定した文字コードでは読み取れません。
['りんご', 'みかん', 'バナナ']この結果から分かるのは、「このCP932教材をUTF-8としては読めなかった」ということです。すべてのUnicodeDecodeErrorを、cp932に変えれば解決できるわけではありません。作成元の設定やファイルの破損なども確認します。
CP932とShift_JISを、完全に同じものとして扱わない
Pythonにはcp932とshift_jisが別々に用意されています。この教材では丸数字の①を使い、CP932では符号化できても、Pythonのshift_jisではUnicodeEncodeErrorになることを実行確認しました。
出力元が「Shift_JIS」と呼んでいても、その名称だけで細かな仕様が分からない場合があります。利用するシステムの仕様や出力設定を確かめ、既知の日本語・記号を含むサンプルで検証しましょう。参考:Pythonの標準文字コード一覧
元ファイルを残してUTF-8へ変換する
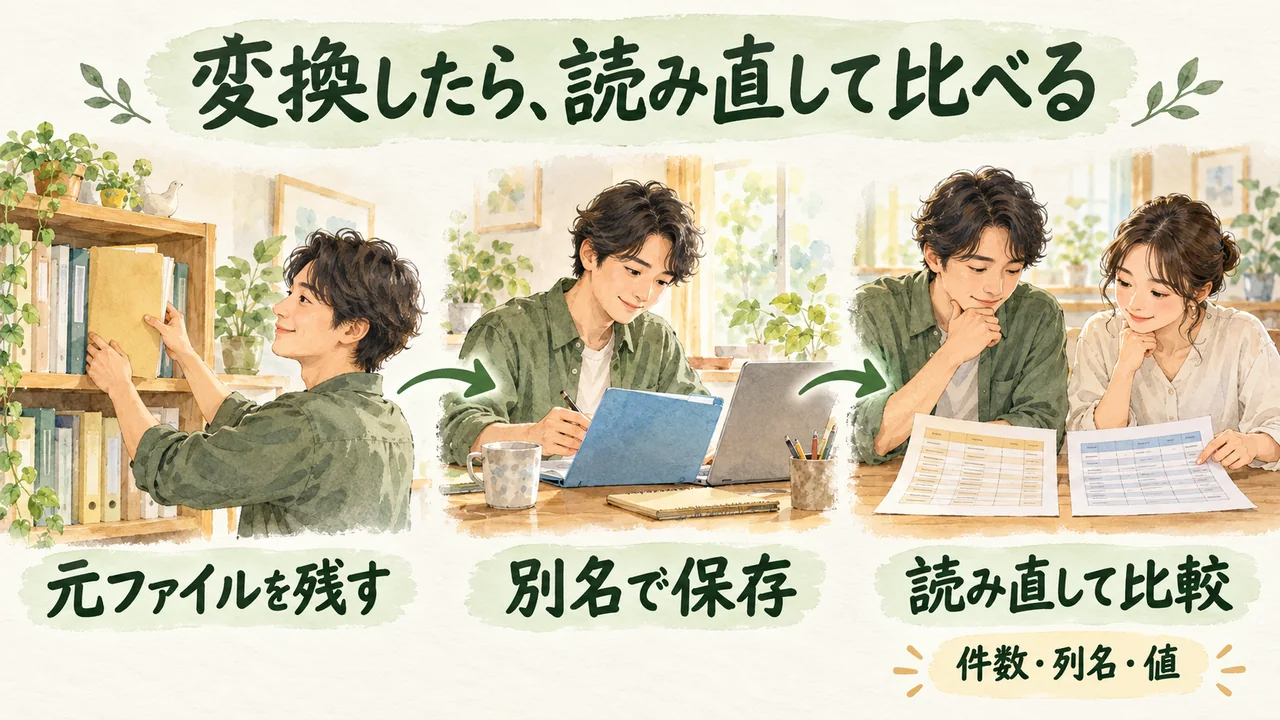
文字コードをそろえて渡す必要がある場合も、元のCSVへ直接上書きせず、別名で書き出します。次のコードは、CP932の教材を読み、converted_utf8_bom.csvというBOM付きUTF-8のファイルを作ります。
from pathlib import Path
import csv

folder = Path(__file__).resolve().parent
source = folder / "sample_cp932.csv"
target = folder / "converted_utf8_bom.csv"

# 小さな教材CSVを、確認済みの文字コードで読む。
with source.open(encoding="cp932", newline="") as f:
    original_rows = list(csv.reader(f))

# "x"は新規作成専用。既存の同名ファイルは上書きしない。
try:
    with target.open("x", encoding="utf-8-sig", newline="") as f:
        csv.writer(f).writerows(original_rows)
except FileExistsError:
    raise SystemExit("保存先が既にあります。別の名前を指定してください。")

with target.open(encoding="utf-8-sig", newline="") as f:
    converted_rows = list(csv.reader(f))

if converted_rows != original_rows:
    raise ValueError("変換前後の値が一致しません。")

print("列名:", converted_rows[0])
print("データ件数:", len(converted_rows) - 1)
print("内容一致:", converted_rows == original_rows)
print("BOM:", target.read_bytes()[:3].hex(" "))
python3 04_convert.pyを初めて実行した結果:
列名: ['商品', '数量']
データ件数: 3
内容一致: True
BOM: ef bb bf"x"は新しいファイルを作るためのモードです。同じ名前の出力が既にある場合、このコードは上書きせずに停止します。もう一度試すなら、targetのファイル名を、まだ使っていない別の名前に変更してください。元のsample_cp932.csvは読み取り専用で開いています。参考:Python公式のopen
読み直した結果を、列名を含む全行・全列の文字列として比較しています。文字コードが変わるため、ファイルのバイト列が同一になることを求めているわけではありません。この練習では、元ファイルのハッシュが変化していないことも確認しました。
ここではBOM付きで出力しましたが、渡す先がBOMなしUTF-8を指定しているなら、出力側と読み直し側をutf-8に合わせます。受け取るシステムの仕様が基準です。utf-8-sigなら、すべての表計算ソフトや取り込み処理で同じ動作になる、という保証はありません。
また、このコードは3件の小さな教材をメモリに読み込む例です。大容量のCSVや、列の型・空欄・重複の検証までを一度に解決するものではありません。集計時の値の確認は、PythonのCSV集計教材で練習できます。
errors=ignoreで消さず、元データと結果を確かめる
エラーを止めるためにerrors="ignore"を加えると、読めない部分が消えることがあります。教材の05_no_silent_loss.pyでは、「あ」をCP932のバイト列にして、誤ったUTF-8指定で読んだ場合を比較します。
# 練習用の短いバイト列だけを使う。実ファイルは変更しない。
raw = "あ".encode("cp932")
print("正しい読み方:", repr(raw.decode("cp932")))
print("ignore:", repr(raw.decode("utf-8", errors="ignore")))
print("replace:", repr(raw.decode("utf-8", errors="replace")))

# CP932で表せても、Pythonのshift_jisでは表せない文字の例。
print("CP932の丸数字:", "①".encode("cp932").hex(" "))
try:
    "①".encode("shift_jis")
except UnicodeEncodeError as error:
    print("shift_jis:", type(error).__name__)
実行結果:
正しい読み方: 'あ'
ignore: ''
replace: '��'
CP932の丸数字: 87 40
shift_jis: UnicodeEncodeErrorignoreの結果が空文字になったのは、文字が直ったからではありません。replaceも、元の「あ」を復元する処理ではなく、読めない部分を代替文字にしています。元データとの照合が必要な場面で、エラーが出なくなったことだけを合格にしないでください。
変換後は、次の項目を、正しい内容が分かっている元データと比べます。
- 列名と列の順番は同じか。
- ヘッダーを除いたデータ件数は同じか。
- 日本語、記号、IDなどの値が欠けたり変わったりしていないか。
- 数量などを数値として使うなら、既知の合計と一致するか。
- 渡す先で実際に読み直し、同じ値を取り出せるか。
すでに文字化けした状態で保存し直したファイルは、読み方を変えるだけで元に戻せるとは限りません。変換を繰り返す前に、作成元から元のファイルを再取得できるか確かめます。
文字コードが分からないときに確認すること
順に文字コードを試してエラーが出なかったとしても、それだけで正しいと断定はできません。まず、出力したアプリやシステムの設定、仕様書、作成者への確認を使います。
問い合わせるときは、「CSVが壊れています」だけでなく、ファイル名、出力方法、試した指定、見えているエラーを伝えると確認しやすくなります。海外の相手なら、次のように短く聞けます。
Could you confirm the character encoding used for this CSV file?
このCSVファイルで使われている文字コードを確認してもらえますか。
必要なら、Does the UTF-8 file include a BOM?(そのUTF-8ファイルにはBOMが付いていますか)も続けられます。
AIへ調査を頼む場合も、確認できた文字コード、最小限の架空サンプル、エラー文を分けて渡します。会社のCSVそのものを無断で貼らず、利用が認められた環境と情報の範囲に合わせてください。エラー文の読み方は、Pythonの英語エラーメッセージを読む練習でも扱っています。
練習問題とよくある質問
練習:同じ値が読めたかを、自分で確かめる
問題1:BOM付きUTF-8で最初の列名が'\ufeff商品'になりました。この教材では、どのencodingを使うと列名を'商品'として読めますか。
解答:utf-8-sigです。ファイルの先頭のBOMを処理できます。
問題2:数量の合計が9だったら、商品名の日本語も正しいと判断してよいでしょうか。
解答:それだけでは判断できません。列名・件数と、商品名などの各値も、正しい元データと照合します。
問題3:変換コードを2回実行したら「保存先が既にあります」と表示されました。元CSVを消す必要がありますか。
解答:ありません。元ファイルは残し、出力先のtargetを新しい名前に変更して試します。
utf-8-sigを指定すれば、CP932も読めますか?
UTF-8のBOMを扱う指定なので、CP932を自動変換して読むわけではありません。確認できた文字コードを指定してください。
pandasを入れないと直せませんか?
この教材の読み取り・BOM確認・変換には不要です。標準ライブラリのcsvとpathlibを使っています。
コードを対話画面へ貼ると、__file__のエラーになります
教材は保存した.pyファイルを実行する形式です。__file__でコード自身の場所を調べ、そのフォルダーのCSVを開いています。同じ名前のファイルへ保存し、READMEのコマンドで実行してください。
CSVの文字化けに出会ったら、まず元ファイルを残し、「保存時の文字コード」「読むときの指定」「元データとの一致」を順に確かめてみてください。値が正しく読めたことを確認してから、集計や次の作業へ進みましょう。
公式資料・実行確認:2026年10月6日。教材コードはPython 3.12.14/macOSで検証。CSVは架空の商品3件を使う独自教材です。写真・水彩図解はAI生成の学習イメージで、実在の受講生や講師を示していません。
英語でIT・AIを学べるKredo
英語×IT・AIのスキルを身につけてグローバルに活躍しませんか?
当メディアを運営しているKredoは、英語×ITをオンラインで学ぶ「Kredoオンラインキャンプ」と、フィリピンのセブ島で英語とIT・AIを学ぶ「KredoIT留学」「KredoAI留学」を提供しています。これまでの卒業生は3,000名以上。卒業生の多くが、国内外のIT企業への転職、フリーランスなどへのキャリアチェンジを実現しています。これからの時代に必要な英語×IT・AIのスキルを身につけてグローバルに活躍しませんか?