PythonでCSVを読むときに列がずれるなら、単純なカンマ分割をやめ、標準ライブラリのcsv.readerで読み込むのが基本です。メモ欄に入ったカンマや改行も、CSVでは1つの値の一部になり得ます。見た目の1行と、データの1件は同じとは限りません。
この記事では、カンマ・改行・引用符を含む4件の学習記録を使い、単純な分割が失敗する理由と、正しく読めたかを確かめる方法を解説します。データは編集部が作成した架空の教材です。Python 3.9.6で実行し、件数・列数・文字の保持など12項目を確認しています。
この記事でわかること
- 画面上ではヘッダー込み6行でも、CSVとしてはヘッダー1件+データ4件。
- メモの「list, dict」は、カンマを含む1つの値。
- メモの途中の改行と、
said "done"の引用符を保持。 - 学習時間を数値へ変換して合計すると110分。
CSVの列がずれる原因は、区切りと値の取り違え
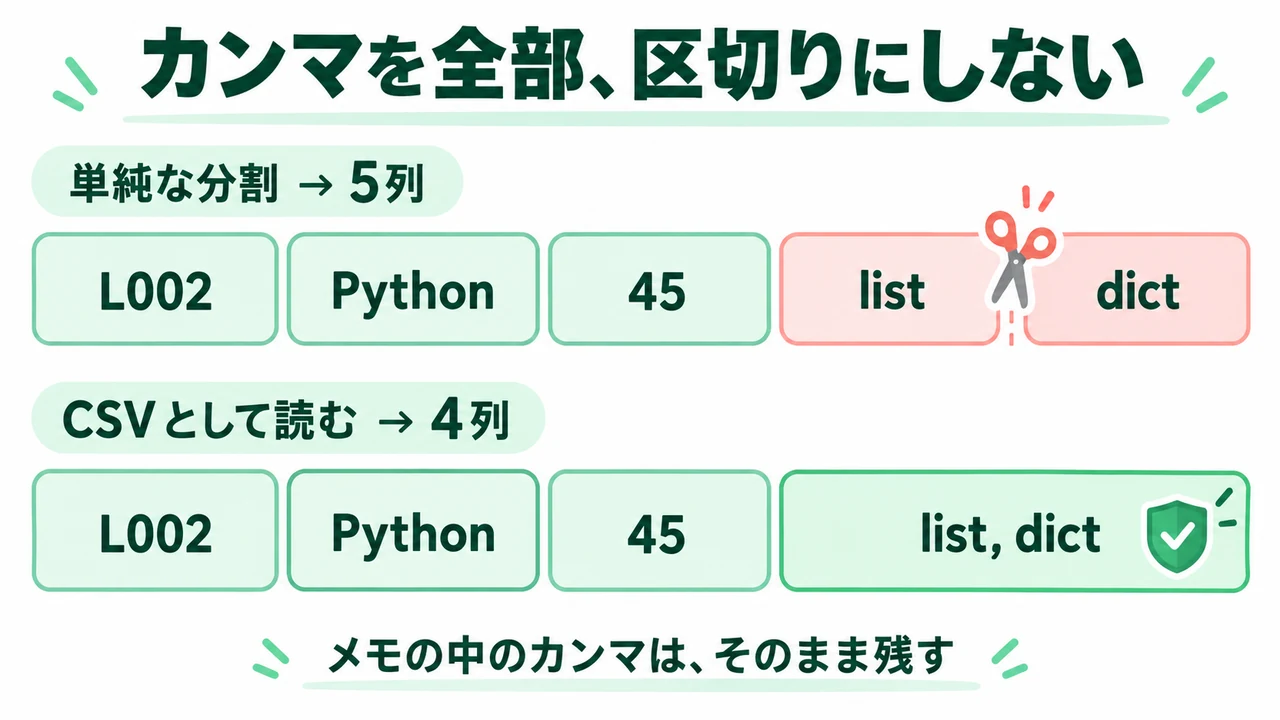
単純にカンマを探して切る処理は、そのカンマが「列の区切り」か「メモの中の文字」かを区別しません。次のCSVの1行を見てください。
L002,Python,45,"list, dict"本来は、ID、科目、時間、メモの4列です。ところが、文字列にsplit(',')を使うと、メモの途中でも分割されて5つになります。
| 読み方 | メモ部分の結果 |
|---|---|
| 単純なカンマ分割 | "listと dict"に分かれ、列が1つ増える |
| CSVとして読み取り | list, dictという1つの文字列になる |
CSVの読み取りには、区切りと引用符のルールを扱える処理を使います。Pythonのcsv公式ドキュメントには、reader、DictReader、writerが用意されています。ファイルを渡すときのnewline=''や、読み取った値が基本的に文字列になる点も確認できます。
csv.readerでCSVを正しく読み込む方法
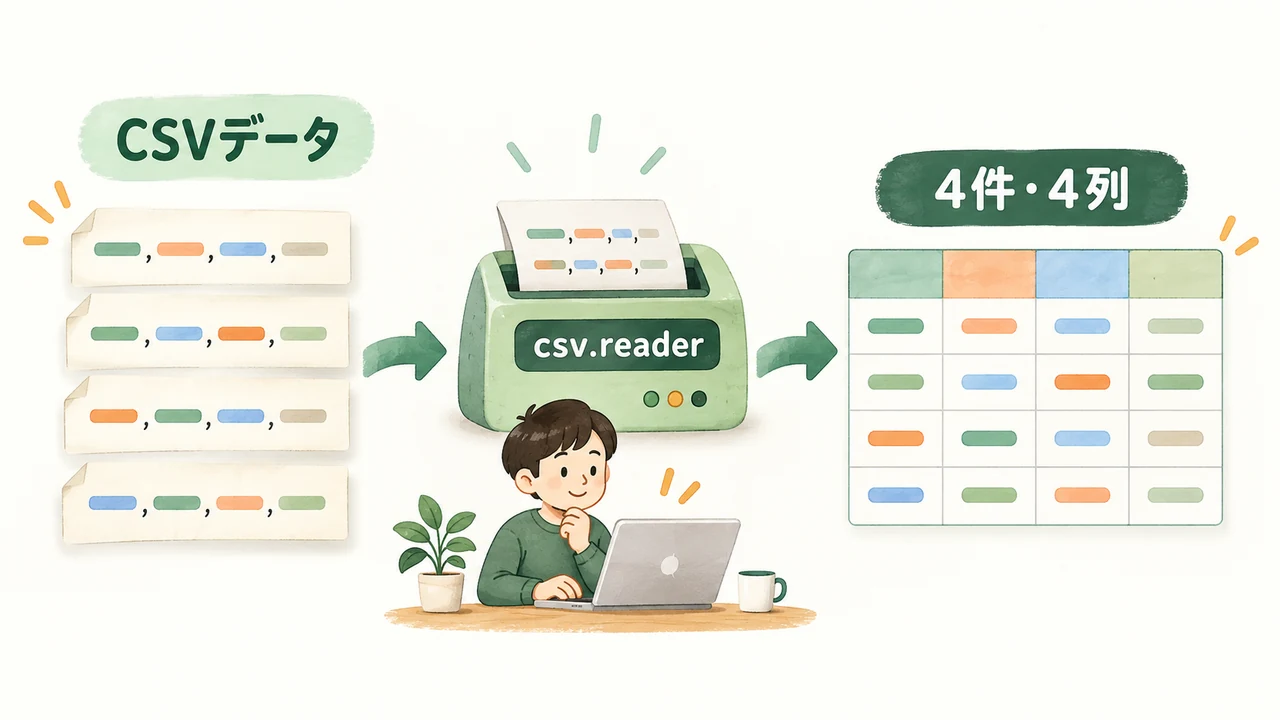
次のコードは、外部ライブラリやファイルの準備なしで動かせます。新しいファイルにcsv_practice.pyという名前で保存して実行してください。Python標準ライブラリのcsvとioだけを使います。
import csv
import io

text = '''record_id,subject,minutes,memo
L001,English,30,review
L002,Python,45,"list, dict"
L003,JavaScript,20,"first line
second line"
L004,English,15,"said ""done"""
'''

rows = list(csv.reader(io.StringIO(text, newline="")))
header, records = rows[0], rows[1:]

print("physical lines:", len(text.splitlines()))
print("data records:", len(records))
print("columns:", [len(row) for row in rows])
for record in records:
print(repr(record))Mac・Linuxではpython3 csv_practice.py、WindowsでPythonランチャーを使っている場合はpy csv_practice.pyで実行できます。表示された結果は、次のとおりです。
physical lines: 6
data records: 4
columns: [4, 4, 4, 4, 4]
['L001', 'English', '30', 'review']
['L002', 'Python', '45', 'list, dict']
['L003', 'JavaScript', '20', 'first line\nsecond line']
['L004', 'English', '15', 'said "done"']repr()を使っているため、メモ内部の改行は\nとして見えます。2文字のバックスラッシュとnに置き換えて保存したという意味ではなく、文字列の中の改行を確認しやすい形で表示しています。
実行できない場合は、ファイル名をcsv.pyにしていないかも確かめてください。標準ライブラリと同じ名前のファイルが、読み込み先の混同につながることがあります。エラー文の読み方は、Pythonの英語エラーを読む手順で確認できます。
ここからは、読み取ったメモの値を1つずつ見ていきましょう。
カンマを含むメモは、全体を引用符で囲む
今回の"list, dict"では、外側の引用符が値の境界を表しています。読み取り後の値はlist, dictです。外側の引用符そのものをメモとして保存したいわけではありません。
単純分割で列が増えたあと、隣の列を結合して修正しようとすると、別の位置にカンマがあるデータでまた壊れます。元のCSVを構造として読むところへ戻りましょう。
改行を含むメモは、複数行に見えても1レコード
L003は、メモの途中で改行しています。このためテキストを行ごとに数えると、ヘッダーを含めて6行です。しかしcsv.readerで読むと、ヘッダーを含めて5レコードになります。
text.splitlines()で先に分けた結果を「1要素=1件」と決めると、second lineだけを別の記録として扱ってしまいます。件数を数えるタイミングは、CSVとして読み取ったあとです。
メモに引用符を含める場合は、二重に表す
今回のCSVにある"said ""done"""は、読み取るとsaid "done"になります。この教材では、値の中の二重引用符を2つ重ねて表す設定を使っています。
外側の引用符と、値に含めたい引用符の役割が違います。CSVを書き出す際も、自分で引用符を付け足すより、後述のcsv.writerへ値の配列を渡すと扱いやすくなります。
DictReaderで列名を指定し、数値を集計する
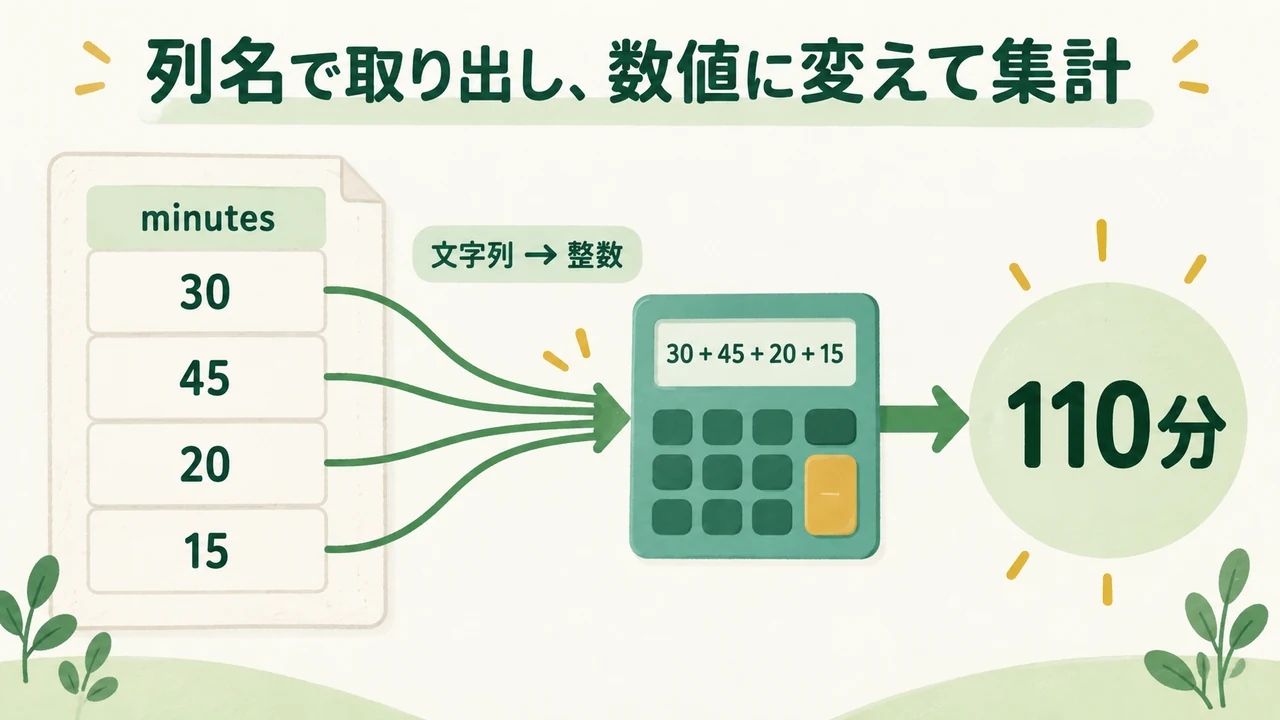
列番号のrow[2]だけでは、何を取り出しているか分かりにくいことがあります。ヘッダー付きのCSVなら、列名をキーにするDictReaderも使えます。先ほどのコードの末尾へ、次を追加してみてください。
records_by_name = list(csv.DictReader(io.StringIO(text, newline="")))
total = sum(int(row["minutes"]) for row in records_by_name)
print("total minutes:", total)
print("second memo:", records_by_name[1]["memo"])結果はtotal minutes: 110、second memo: list, dictです。30などの時間は読み取り直後には文字列なので、ここではint()で整数へ変換しています。
この計算は、今回の4件が有効な整数だと分かっている教材用です。実際のCSVでは、空欄や「30分」が混ざる場合もあります。値の確認と除外理由の残し方は、PythonでCSV集計を自動化する実習で詳しく練習できます。
列数と値を確認してから、CSVを書き出す
csv.readerを使っても、すべての行の列数や、値の意味まで自動で検証するわけではありません。たとえばid,memoという2列のヘッダーに対してX,a,bという3列の行を渡しても、今回の確認では3つの値として読み取られました。
「エラーにならなかったから正しい」と判断せず、次の順で確かめます。
| 確認する段階 | 今回の教材での答え |
|---|---|
| ヘッダー | record_id、subject、minutes、memoの4項目 |
| データ件数 | ヘッダーを除いて4件 |
| 各レコードの列数 | すべて4列 |
| 文字が保持されたか | カンマ、メモ内部の改行、doneの引用符が残る |
| 値と集計結果 | minutesを整数にでき、合計110分 |
列数が違うデータを止めたいなら、先ほどのrowsに対して、たとえば次の確認を追加できます。
expected_header = ["record_id", "subject", "minutes", "memo"]
if rows[0] != expected_header:
    raise ValueError("Unexpected header")

for record_number, row in enumerate(rows[1:], start=1):
    if len(row) != len(expected_header):
raise ValueError(f"Record {record_number}: unexpected column count")ここでのrecord_numberは、データの何件目かを表します。改行を含むメモがあるため、テキストファイルの物理行番号と同じだとは限りません。エラーの報告でも、「3行目」と「3件目」を混同しないようにします。
ファイルを開くときと、書き出すときの基本
文字列ではなくUTF-8のCSVファイルを読む場合は、StringIOの代わりにファイルを開きます。教材を保存したフォルダーにsample.csvがある例です。
with open("sample.csv", encoding="utf-8", newline="") as f:
file_rows = list(csv.reader(f))encodingは実際のファイルの文字コードに合わせます。日本語が文字化けする問題は、カンマや引用符による列ずれとは別に切り分けてください。値に含まれる改行を保つため、不要なstrip()や改行の一括削除も避けます。
CSVへ書き出すときは、文字をカンマでつなぐ代わりにwriterへ渡します。次の例は、ファイルを上書きせず、メモリ上へ書いて読み直す練習です。
output = io.StringIO(newline="")
csv.writer(output).writerows(rows)
restored = list(csv.reader(io.StringIO(output.getvalue(), newline="")))
print("round trip:", restored == rows)今回の結果はround trip: Trueでした。CSV文字列が元と完全に同じかではなく、読み直した値の配列が同じかを比べています。改行形式などが変わっても、必要な値を保てているかが確認のポイントです。
練習問題:メモを変えても、件数と列数は同じか
L002のメモを"list, dict, tuple"へ変えて再実行してください。メモのカンマは増えますが、正しくCSVとして読めていれば、データは4件、各レコードは4列のままです。
次に、csv.readerを使わず[line.split(',') for line in text.splitlines()]にすると、どこが変わるか比べてみましょう。実務データを修正する前に、こうした小さな架空データで原因を再現すると、処理の違いを確かめやすくなります。
よくある質問
pandasを入れないとCSVは読めませんか?
今回のような読み取り・書き出しは、標準ライブラリのcsvで行えます。まずファイルの構造と値を確認し、そのあと集計・分析の規模や目的に応じて道具を選んでください。
メモのカンマを全部削除すればよいですか?
元の値を変えてしまうため、列ずれの解決としては勧めません。カンマを含めたままCSVとして読みます。入力形式が壊れている場合も、出力元の仕様を確認してから修正方針を決めましょう。
セミコロン区切りのファイルにも使えますか?
区切りがセミコロンだと分かっているなら、csv.reader(f, delimiter=';')のように指定できます。拡張子だけで決めず、出力元の設定と実際のデータを確認します。
正常に読めたら、そのまま集計してよいですか?
列数・必須値・数値の範囲なども確認してください。構造として読めることと、集計対象にしてよいことは別です。まず小さなデータで期待する件数と合計を決め、結果を照合しましょう。
まとめ:列ずれは、元データを削らず読み方から直す
今回の4件なら、目で見て正解を確かめられます。件数、列数、カンマや改行の保持、合計の順に確認し、次に除外理由も残すCSV集計実習へ進むと、読み取りと値の検証をつなげて練習できます。
Pythonや英語を使って、ITを学びたい方へ
KredoではITと英語を学ぶ留学プログラムを案内しています。現在の経験や、作ってみたいものに合わせて学習方法を相談できます。
英語でIT・AIを学べるKredo
英語×IT・AIのスキルを身につけてグローバルに活躍しませんか?
当メディアを運営しているKredoは、英語×ITをオンラインで学ぶ「Kredoオンラインキャンプ」と、フィリピンのセブ島で英語とIT・AIを学ぶ「KredoIT留学」「KredoAI留学」を提供しています。これまでの卒業生は3,000名以上。卒業生の多くが、国内外のIT企業への転職、フリーランスなどへのキャリアチェンジを実現しています。これからの時代に必要な英語×IT・AIのスキルを身につけてグローバルに活躍しませんか?