こんにちは、Kredo編集部です。AIに質問すると答えが返ってきますが、その間にプログラムの中では何が起きているのでしょうか。
機械学習を使うAIでは、人が予測のルールをすべて書く代わりに、データからモデルの数値や条件を調整します。例を使ってモデルを調整するのが「学習」、調整済みのモデルで答えを計算するのが「推論」です。ChatGPTのような生成AIも、この区別から見ると仕組みをつかみやすくなります。
この記事では、AIの4つの構成要素から、学習・推論・生成AIの違いまで、図と実際に動くPythonコードで解説します。まず数値が変わる様子を見て、次に学習した結果をファイルへ保存し、別のプログラムで使ってみましょう。コードをまだ読めない方は、図と計算表だけでも流れを追えます。
- AI・機械学習・生成AIの関係を説明する
- 学習と推論を区別し、簡単なPython例で確認する
- 生成AIの回答を使うときに、何を確認すべきか判断する
内容・コード確認:2026年10月7日。Python 3.12.14 / scikit-learn 1.8.0 / NumPy 2.5.3で実行確認。水彩図は概念図、学習曲線は本文の教材コードを実行した計算結果です。
AI(人工知能)とは?よく出てくる言葉の関係
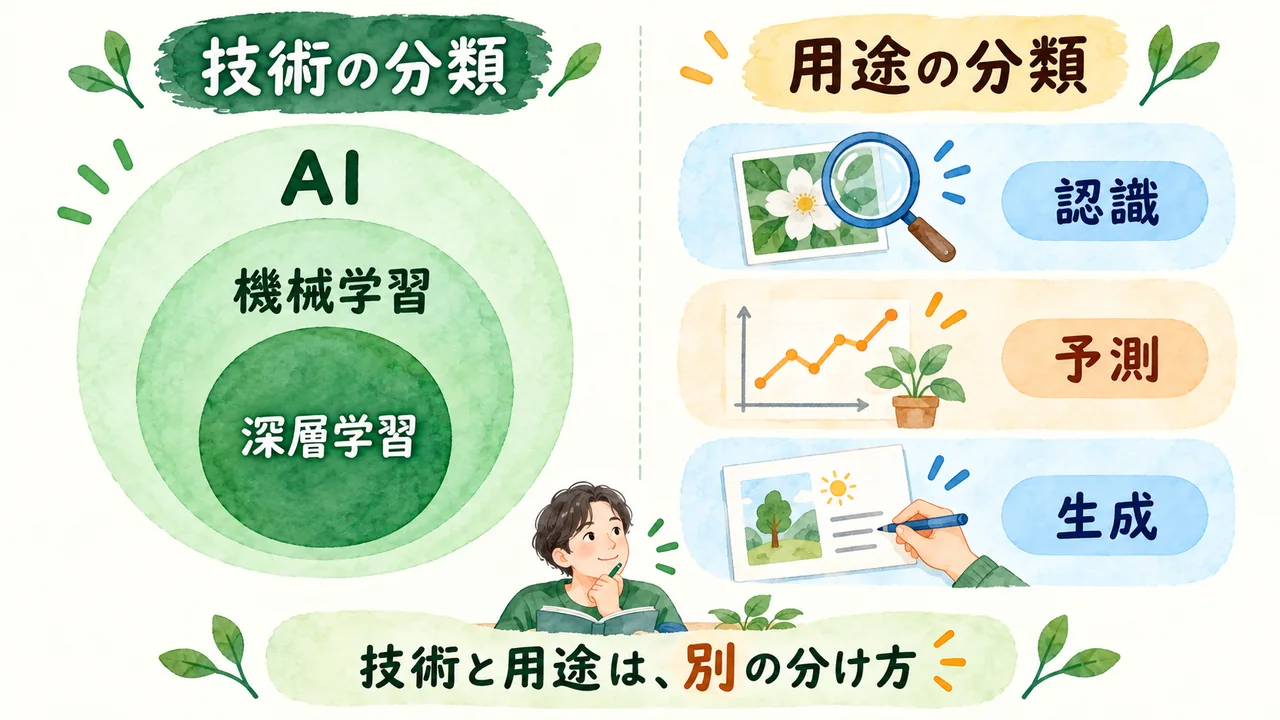
AIの仕組みを理解するには、まず「AI」「機械学習」「ディープラーニング」「生成AI」の関係を押さえておくとわかりやすくなります。
| 言葉 | 意味 | 身近な例 |
|---|---|---|
| AI(人工知能) | 認識・予測・判断・言葉の生成など、人間の知的な作業をコンピューターで行う技術の総称 | 下の3つすべてを含む |
| 機械学習 | データから規則性を学び、予測や判断をする方法。今のAIの中心となる技術 | 迷惑メールの判定、売上の予測、おすすめ商品の表示 |
| ディープラーニング(深層学習) | 機械学習の方法の1つ。何層にも重ねた「ニューラルネットワーク」を使う | 画像認識、音声認識、翻訳 |
| 生成AI | 文章・画像・音声などを新しく作り出すAI。多くはディープラーニングで作られている | ChatGPTなどの対話AI、画像生成AI |
AIの中に機械学習があり、その方法の1つがディープラーニングです。一方、生成AIは「何をするAIか」という用途から見た呼び方です。多くの生成AIは深層学習を使いますが、4つの言葉を単純な4重の入れ子にすると分類の基準が混ざってしまいます。AIには、人が決めたルールで動くものもあります。この記事では主に、データから学ぶ機械学習を扱います。
AIは何でできている?4つの要素
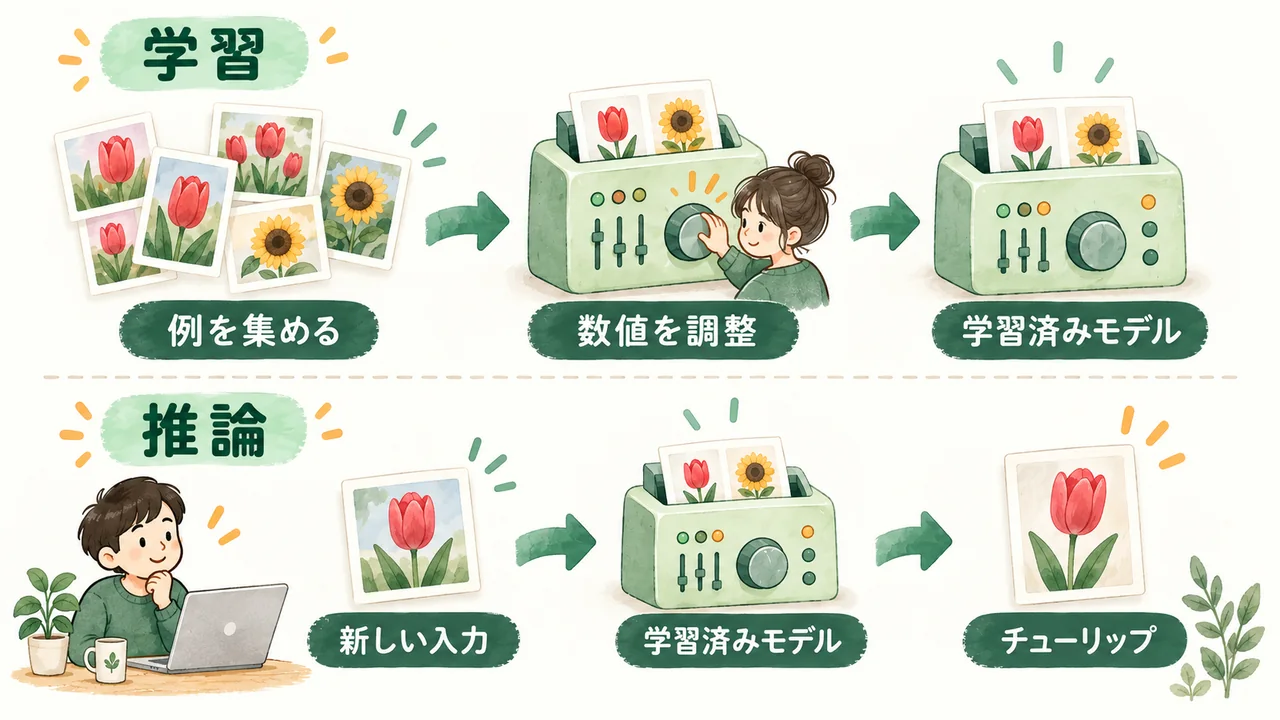
機械学習を使うAIシステムは、特別な1台の機械というより、次の4つの要素の組み合わせで動きます。
| 要素 | 役割 |
|---|---|
| データ | AIが学ぶための材料。画像、文章、数値など。量と質がAIの性能を大きく左右する |
| モデル | 入力から出力を計算する仕組み。数式や構造と、学習で決まった数値・条件などを組み合わせる |
| プログラム | モデルに学習させる手順や、学習したモデルを使って答えを出す手順を書いたコード。Pythonで書かれることが多い |
| 計算資源 | 大量の計算をこなすコンピューター。ディープラーニングでは、並列計算が得意なGPUがよく使われる |
モデルの規模は目的によって異なります。この記事で最初に試すモデルは、重みとバイアスの2つの数値だけです。「AIを作るには必ず大規模な設備が必要」と考える前に、小さな例で流れをつかむと理解しやすくなります。
また、AIの一生は大きく2つの段階に分かれます。データを使ってパラメータを決める「学習(トレーニング)」と、学習済みのモデルに新しい入力を与えて答えを出す「推論」です。私たちが学習済みモデルに質問したり、画像を判定させたりする処理は、基本的に推論です。会話の内容を参照して回答することと、その場でモデルの重みを学習し直すことは別です。
AIの仕組み:普通のプログラムとの違い
AIもプログラムで動きます。違いを理解するには、人が直接書くルールと、学習で調整する部分を分けて見るとよいでしょう。機械学習でも、目的、モデルの種類、データの扱い方、学習手順は人が設計します。
| 普通のプログラム | 機械学習(AI)のプログラム | |
|---|---|---|
| ルールを決めるのは | 人間(条件分岐などで1つずつ書く) | データから自動で学ぶ |
| 人が用意するもの | ルールそのもの | データと正解(または目的)、学習の手順 |
| 迷惑メール判定の例 | 「件名に『当選』があれば迷惑メール」などを人が書く | 迷惑メールと普通のメールの例を大量に与え、見分け方を学ばせる |
| 向いていること | ルールがはっきりしている処理(計算、手続き) | ルールを書き出しにくい処理(画像の判別、言葉の理解) |
コードで見る「学習」の仕組み
ここで試す教師あり学習は、予測と正解のズレを手がかりに、モデルの数値を調整する処理です。次の例では、人が式の形をy = w * x + bと決め、wとbを4組のデータから学ばせます。追加ライブラリは不要です。
# 入力xと正解yの組(y = 2x + 1 の関係になっている)
data = [(1, 3), (2, 5), (3, 7), (4, 9)]

w = 0.0  # 重み(最初は0)
b = 0.0  # バイアス(最初は0)
learning_rate = 0.01  # 1回にどれだけ調整するか

for step in range(2000):
    for x, y in data:
        prediction = w * x + b        # 今のwとbで予測する
        error = prediction - y        # 正解とのズレ
        w -= learning_rate * error * x  # ズレが小さくなる方向に少し調整
        b -= learning_rate * error

print(f"学習した式: y = {w:.2f}x + {b:.2f}")
print(f"x = 10 のときの予測: {w * 10 + b:.2f}")
実行すると、次のように表示されます。
学習した式: y = 2.00x + 1.00
x = 10 のときの予測: 21.00最初は0だったw(重み)とb(バイアス)が、「予測する→正解とのズレを測る→ズレが小さくなる方向に少し調整する」を繰り返すうちに、2と1に近づきました。予測に使う処理へ「y = 2x + 1」を直接設定せず、4組のデータから係数を調整できました。ただし、この例では人が「直線の式で予測する」と決めています。また、x = 10は学習範囲の外です。この人工データでは正しく予測できても、現実のデータで範囲外の予測が当たる保証はありません。
ニューラルネットワークでも、多数の重みなどを損失が小さくなる方向へ更新します。ただし、機械学習の方法がすべて勾配降下法を使うわけではありません。次の決定木の例では、データを分ける条件を学びます。
最初の1件を、電卓で追ってみる
いきなり2,000回の繰り返しを読むより、最初のデータx = 1, y = 3だけ見てみましょう。最初のwとbは0、学習率は0.01です。
| コードがすること | 最初の計算 | 意味 |
|---|---|---|
| prediction = w * x + b | 0 × 1 + 0 = 0 | 今のモデルの予測 |
| error = prediction – y | 0 − 3 = −3 | 正解より3小さい |
| w -= 0.01 * error * x | 0 − 0.01 × (−3) × 1 = 0.03 | 傾きを少し増やす |
| b -= 0.01 * error | 0 − 0.01 × (−3) = 0.03 | 切片を少し増やす |
| 同じxで予測を見直す | 0.03 × 1 + 0.03 = 0.06 | 0より少し3へ近づく |
最後の行は説明のための確認です。実際のループは、更新した数値で次のデータx = 2, y = 5へ進みます。4件を一巡するのを1周(エポック)と数えるため、2,000周では8,000回の更新になります。
この例の更新式は、1件ごとの二乗誤差の半分を小さくする向きを使っています。こうした勾配降下法の考え方はGoogleの線形回帰教材でも確認できます。学習率が大きすぎる場合など、常にうまく近づくとは限りません。
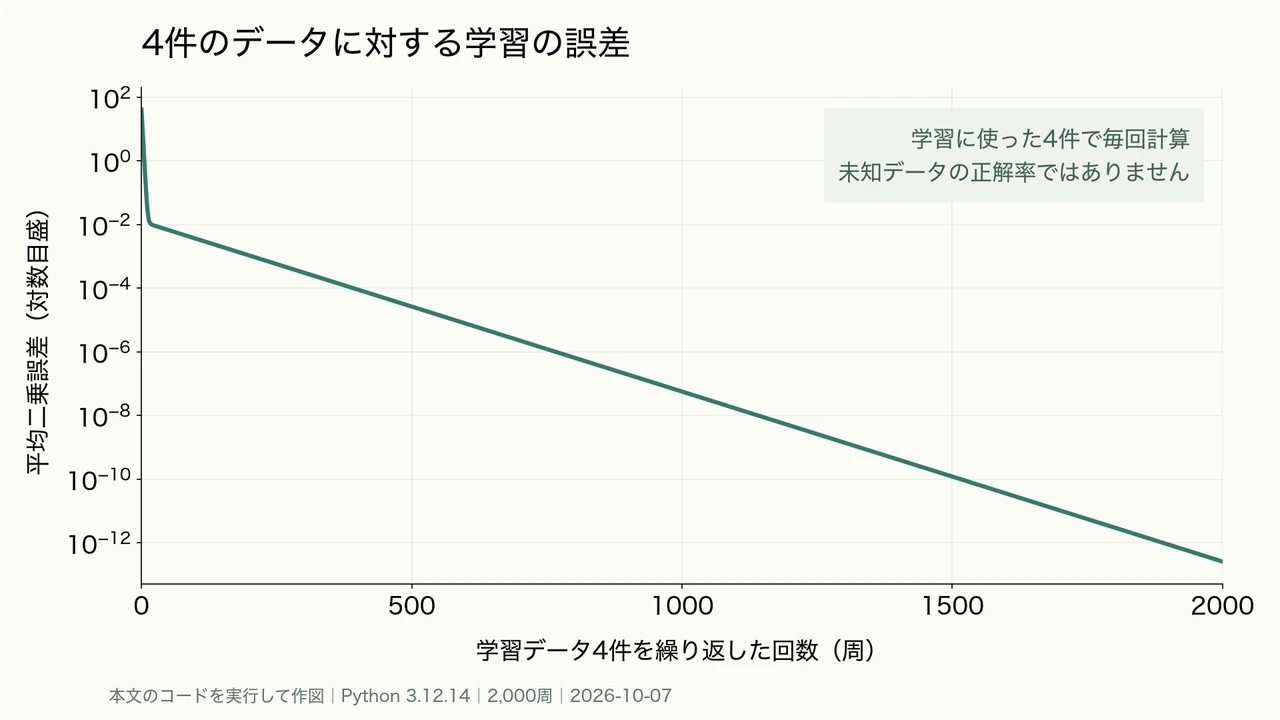
実行結果では、学習前のMSEは41、10周後は約0.047、2,000周後は約2.56×10⁻¹³でした。これは人が用意した、きれいな直線上の4点です。学習に使ったデータへの当てはまりが良いことと、初めて見るデータでも当たることは別なので、後のIrisの例では評価用のデータを分けます。
学習したモデルを保存し、別のプログラムで推論する
毎回最初から学習させる必要があるのでしょうか。この小さな例では、学習したwとbを保存しておけば、別のプログラムから使えます。
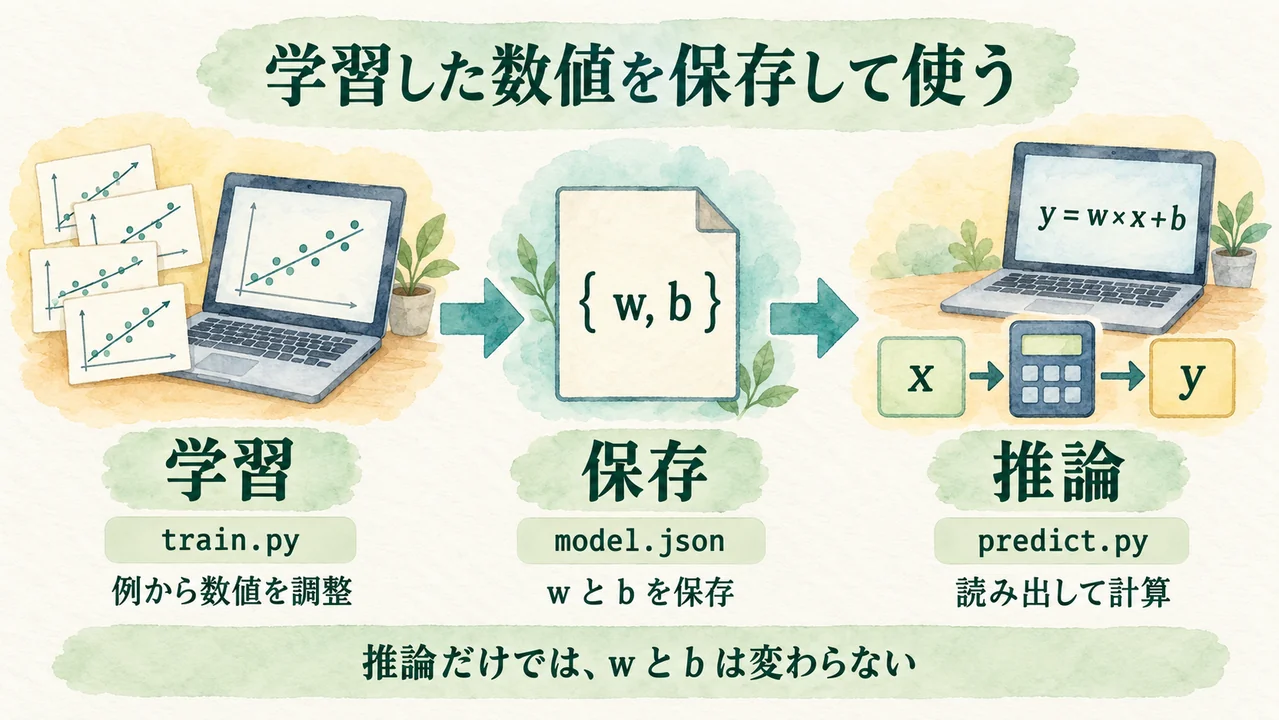
train.py:学習した数値をファイルへ保存する
教材のtrain.pyは、前のコードと同じ計算を行い、最後に次の処理でmodel.jsonを作ります。JSONはデータを書き出す形式で、JSONという形式自体がAIなのではありません。
import json
from pathlib import Path

model_path = Path(__file__).with_name("model.json")
model_path.write_text(
    json.dumps({"w": w, "b": b}, indent=2),
    encoding="utf-8"
)使っているのはPythonの標準ライブラリです。読み書きの仕様はPython公式のjsonモジュールで確認できます。保存される数値はw ≈ 2、b ≈ 1ですが、ファイルには小数点以下を丸めずに残します。
predict.py:保存済みのモデルに入力を渡す
次のコードをpredict.pyとして、train.pyと同じフォルダに保存します。
import json
from pathlib import Path

model_path = Path(__file__).with_name("model.json")
model = json.loads(model_path.read_text(encoding="utf-8"))
x = 10
prediction = model["w"] * x + model["b"]
print(f"x = {x} のときの予測: {prediction:.2f}")先にtrain.py、次にpredict.pyを実行すると、「x = 10 のときの予測: 21.00」と表示されます。推論のコードには、wとbを更新するループがありません。実行前後でmodel.jsonの中身が変わらないことも確認しています。
展開したフォルダで、次の順に実行します。Python 3がpythonで起動する環境は、コマンド名を読み替えてください。
python3 train.py
python3 predict.pypredict.pyのx = 10だけをx = 5に変えると、予測は11.00になります。学習を繰り返さずに入力を変えて計算するのが、この例の推論です。ファイルが見つからない場合は、先にtrain.pyを実行したか、2つのコードが同じフォルダにあるか確認してください。
この教材のモデルは単純な数式と2つの数値です。実用的なモデルには、構造、前処理、入出力の定義なども必要で、すべてをこのJSON形式で保存できるわけではありません。
AIはどのように作られる?開発の5ステップ
AIを作るときは、一般的に次の流れで進めます。
- 目的を決める:何を予測・判断・生成させたいのかを決める(例:商品の画像から種類を見分けたい)
- データを集めて整える:学習に使うデータを集め、正解のラベルを付けたり、形式をそろえたりする。多くの時間がかかる工程
- モデルを選んで学習させる:目的に合う学習の方法(アルゴリズム)を選び、データで学習させる
- 評価する:学習に使っていないデータで、どのくらい正しく答えられるかを確かめる。足りなければデータやモデルを見直す
- サービスに組み込んで運用する:アプリやWebサービスから使えるようにし、使われ方を見ながら改善を続ける
Pythonで機械学習を試すコード例
ステップ2〜4を、Pythonの機械学習ライブラリ「scikit-learn(サイキット・ラーン)」で試すと次のようになります。アヤメという花の、がく片と花びらの長さ・幅(4つの数値)から、3つの品種を見分けるAIです。データ(150件)はscikit-learnに最初から入っています。
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score

# 1. データを用意する(アヤメの花の大きさと品種のデータ)
X, y = load_iris(return_X_y=True)

# 2. 学習用とテスト用に分ける
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0
)

# 3. モデルに学習させる
model = DecisionTreeClassifier(random_state=0)
model.fit(X_train, y_train)

# 4. 学習に使っていないデータで評価する
predictions = model.predict(X_test)
print("正解率:", accuracy_score(y_test, predictions))scikit-learnはpython -m pip install scikit-learn==1.8.0でインストールできます。実行すると、次のように表示されます(2026年10月7日、Python 3.12.14・scikit-learn 1.8.0で再実行)。
正解率: 0.9777777777777777150件を学習用105件・テスト用45件に分け、この分け方では45件中44件を正しく分類できたという意味です。約97.8%は、この教材と分割条件での結果であり、実務での精度を保証する数字ではありません。model.fit()が「学習」、model.predict()が「推論」にあたります。花の写真を入力しているのではなく、がく片・花びらの長さと幅という4つの測定値を入力している点にも注目してください。データの構成はscikit-learn公式のIrisデータセット説明で確認できます。
print(X_train.shape, X_test.shape)を追加し、(105, 4) (45, 4)になるか確認する。random_state=0を分割処理だけ1に変えて、正解率が変わるか試す。- 「1回のテストで高い点が出た」ことと「未知の現場で安定して使える」ことの違いを、自分の言葉で説明する。
学習用と評価用を分ける理由が分かれば、コードを動かすだけでなく、結果の読み方も一歩進みます。
97.8%という数字をどう読む?比較対象も置く
「正解率が高かった」で終わらず、何と比べた数字かを確認しましょう。同じ45件を、学習データで最も多い種類を毎回答えるだけの方法とも比較しました。
| 方法 | この分割での正解数 | 正解率 | 確認できること |
|---|---|---|---|
| 最頻の種類だけを答える | 11 / 45件 | 約24.4% | 入力の4測定値を使わない基準点 |
| 本文の決定木 | 44 / 45件 | 約97.8% | この評価用データでは基準点より良かった |
基準点にはDummyClassifierのmost_frequentを使いました。この分割の学習用105件ではvirginicaが39件で最多ですが、評価用45件に含まれるvirginicaは11件です。そのため「3種類だから必ず33.3%」にはなりません。
fitに渡したのは学習用105件だけか。- 正解率を計算したのは、学習時に使わなかった45件か。
- テストの結果を見て何度も設定を選ぶなら、最後に確認する別のデータを残しているか。
テスト側の情報を学習や設定選びに使うと、実力以上によく見えることがあります。これをデータ漏洩と呼びます。標準化などの前処理も、学習用だけで必要な値を求め、同じ変換を評価用へ適用します。具体例はscikit-learn公式のよくある誤りで確認できます。今回の簡単な決定木例では、標準化は追加していません。
ディープラーニング(ニューラルネットワーク)の仕組み
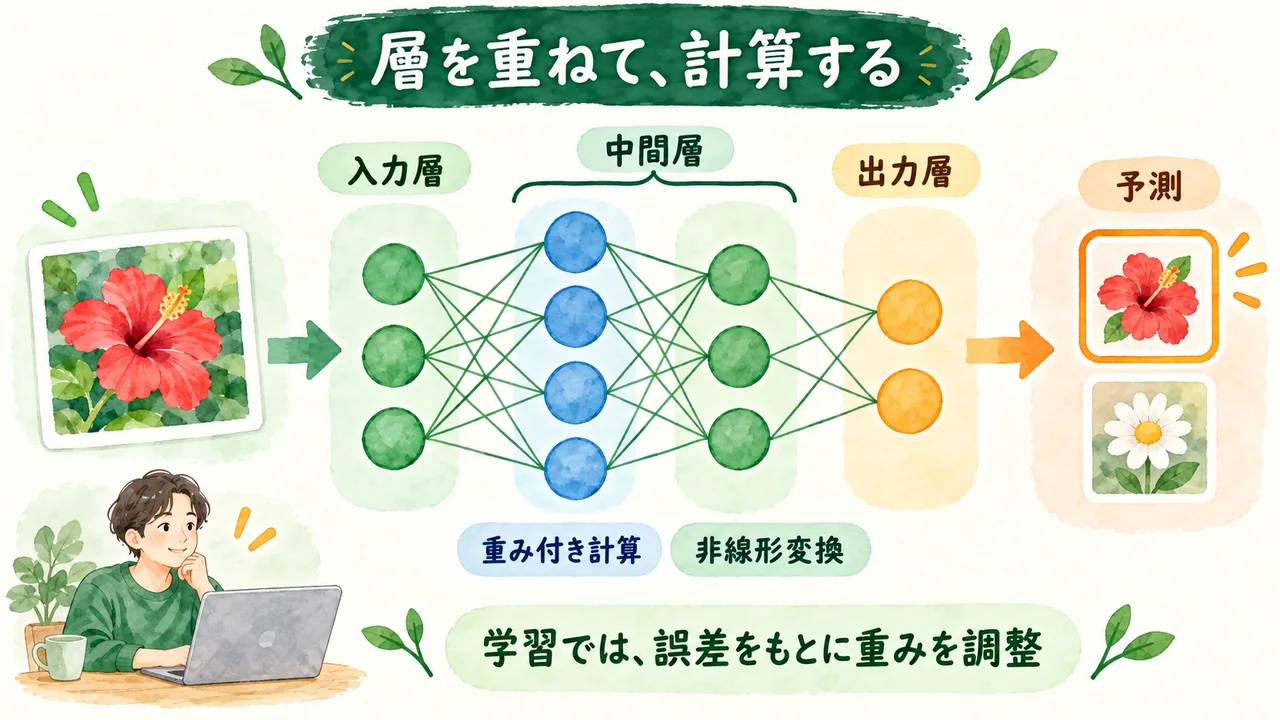
ディープラーニングは、層を重ねたニューラルネットワークを使う機械学習です。神経回路に着想を得た名称ですが、人の脳をそのまま再現したものではありません。
- 入力を数値で受け取る:画像なら画素の値などを、計算できる形にします。
- 重み付きの計算と非線形変換を重ねる:入力に重みを掛け、足し合わせる計算に、活性化関数による変換を組み合わせます。単なる直線では捉えにくい関係を表せるのがポイントです。
- 出力と正解の差から学習する:教師あり学習では損失を計算し、誤差逆伝播で各パラメータに対する勾配を求め、最適化手法で重みなどを更新します。
図の丸は計算の単位、線は情報のつながりのイメージです。花の分類に必要な層数やノード数を指定する設計図ではありません。重み付き計算と非線形変換は、中間層で組み合わせて使います。
画像のどの特徴に注目するかも学習できるため、認識や生成などに広く使われます。仕組みを深く学ぶときは、Googleのニューラルネットワーク教材で、層・重み・活性化関数を順に確認すると理解しやすくなります。
生成AI(ChatGPTなど)の仕組み
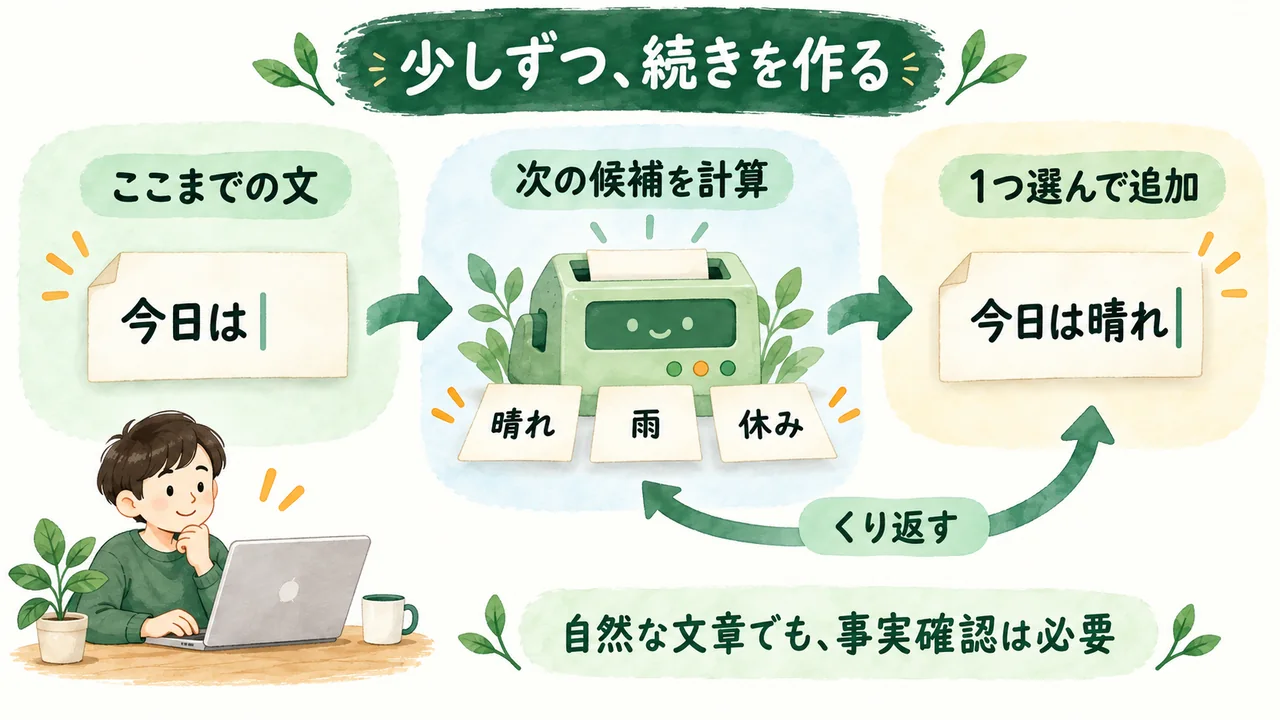
文章を作るAI:「次の言葉」を予測し続ける
ChatGPTのような対話AIの中心にあるのは、大規模言語モデル(LLM)と呼ばれるモデルです。仕組みは次のとおりです。
- 文章を「トークン」という小さな単位(単語や文字のかたまり)に分けて、数値として扱う
- それまでの文章を読み、次に来るトークンの候補ごとに「どのくらい来やすいか」を計算する
- 候補から1つ選んで文章に付け足し、また次のトークンを予測する。これを繰り返して文章を作る
今の大規模言語モデルの多くは、2017年に発表された論文「Attention Is All You Need」で提案されたTransformer(トランスフォーマー)という仕組みがもとになっています。文章の中の「どの言葉がどの言葉と関係が深いか」に注目(アテンション)して計算するのが特徴です。
生成AIはどのように作られたのか
大規模言語モデルの作り方を入門向けに整理すると、「事前学習」と「用途に合わせた追加の学習」に分けられます。実際の手法や工程はモデルによって異なります。
- 事前学習:インターネット上の文章などの膨大なテキストを使い、「次のトークンを予測する」練習を大量に繰り返して、言葉の使われ方や知識をパラメータに蓄える
- 追加の学習:人が作った対話の例で調整したり(ファインチューニング)、人がAIの回答を評価した結果を使って、より望ましい回答をするように学習させたりする(人間のフィードバックによる強化学習、RLHF)
たとえば、OpenAIによる2022年のChatGPT発表では、対話例による調整と人の評価を用いた強化学習が説明されています。これは当時のモデルの説明であり、現在のすべてのモデルの学習工程を表すものではありません。
質問を変えることと、モデルを再学習することの違い
AIに「もっと短く答えて」と頼み、返事が変わっても、その場で重みを書き換えたとは限りません。GoogleのLLM教材では、プロンプトによる調整と追加学習を区別しています。
| 方法 | 何を変えるか | 使う場面の例 |
|---|---|---|
| プロンプトを工夫する | モデルに渡す指示・例・前提 | 「箇条書きで3点」「この例と同じ形式で」と頼む |
| 参照文書を入力に加える | 今回の回答で参照できる情報 | 最新の案内文を渡し、その内容を要約してもらう |
| ファインチューニング | 学習によってモデルのパラメータなどを調整 | 用意した例を使い、特定のタスクへの適応を図る |
前の2つは、入力だけを変える使い方であれば重みの再学習を伴いません。ただし、サービスが会話を保存したり、後日の改善に利用したりするかは別の問題です。利用するサービスの設定と条件を確認してください。
画像を作るAI:ノイズから少しずつ画像を作る
画像生成AIでよく使われるのが拡散モデルです。画像に少しずつノイズ(ざらざらした乱れ)を加えていく過程を逆にたどるように学習し、ノイズだけの状態から少しずつノイズを取り除くことで、新しい画像を作り出します。入力した文章に合う画像になるように、文章の内容も手がかりにして生成します。
拡散モデルの研究例にはDenoising Diffusion Probabilistic Models(2020)があります。画像生成AIにはほかの方式もあり、すべての製品が同じ仕組みで動くわけではありません。
生成AIを使うときの注意点
- もっともらしい間違いをすることがある:生成AIは「それらしい続き」を作る仕組みのため、事実と違う内容を自然な文章で答えることがあります。OpenAIもChatGPTの発表時に、この点を限界として挙げています。重要な情報は元の情報源でも確認しましょう
- 新しい情報には追加の情報源が必要:学習済みの重みだけでは、その後に起きた事実を自動では取得できません。入力文やWeb検索などから新しい情報を参照する場合も、出典と日付の確認が必要です
- 入力する情報に気をつける:個人情報や社外秘の情報を入力してよいかは、使うサービスの規約や勤務先のルールを確認しましょう
AIの仕組みを学ぶのに使われるプログラミング言語
| 言語 | AI分野での使われ方 |
|---|---|
| Python | 機械学習・ディープラーニングの開発で広く使われる。scikit-learn、PyTorch、TensorFlowなどのライブラリがそろっていて、文法も比較的シンプル |
| JavaScript | AIを使ったWebサービスの画面づくりに使う。TensorFlow.jsのように、ブラウザ上で機械学習のモデルを動かすライブラリもある |
これからAIの仕組みを手を動かして学ぶなら、まずはPythonがおすすめです。この記事のコード例も、Pythonをインストールすれば試せます。
初心者がAIの仕組みを学ぶステップ
- 生成AIを実際に使ってみる:ChatGPTなどを使い、得意なこと・苦手なことを体感する。仕組みを学ぶときのイメージがわきやすくなります
- Pythonの基本を学ぶ:変数、条件分岐、繰り返し、関数など、プログラミングの基礎を身につける
- scikit-learnで機械学習を動かす:この記事のコード例のように、データを分けて学習・評価する流れを体験する
- ディープラーニングに進む:PyTorchなどのライブラリで、ニューラルネットワークを動かしてみる
仕組みを深く理解したい場合は、関数とグラフ、微分、確率・統計、行列といった数学の知識も役立ちます。また、AIの論文やライブラリの公式ドキュメント、最新の情報は英語で発表されることが多いため、英語で読めると学べる範囲が大きく広がります。
AIが学習する方法をもっと詳しく知りたい方は「AI(人工知能)が学習する方法・アルゴリズムを徹底解説」、ゲームのAIの作られ方に興味がある方は「ゲームで使う人工知能(AI)はどうプログラミングされている?」も参考にしてください。
仕組みを知ったら、英語でAIを使う練習へ
公式ドキュメントを読み、動かした結果を説明し、分からない点を質問する。この繰り返しは、AIと英語を一緒に学ぶ練習になります。まずはIrisの例について、「入力は何か」「学習と推論はどの行か」を短い英語で説明してみましょう。
The model learns from four measurements of each flower. We test it on data it did not use for training.
「花ごとの4つの測定値から学び、学習に使わなかったデータでテストする」という意味です。用語を並べるより、入力と確認方法を具体的に伝える練習になります。
英語と生成AIの活用を、学習計画から相談する
Kredo AI留学は、セブ島で英語と生成AIの活用を学ぶプログラムです。現在、TOEICスコアによる参加条件は設けていません。目的や現在の学習状況に合わせた受講の相談は、公式案内から確認できます。
仕事への活用を考えている方は「社会人がAIスキルでキャリアアップする方法」も参考にしてください。
AIの仕組みについてよくある質問
AIは何でできていますか?
機械学習を使うAIシステムは、学習用のデータ、予測などを行うモデル、その処理を動かすプログラム、計算資源を組み合わせて作ります。AIすべてが機械学習を使うわけではなく、人がルールを設計する方法もあります。
AIはどのように作られたのですか?
一般的には、目的を決め、データを集めて整え、モデルに学習させ、学習に使っていないデータで評価し、サービスに組み込む、という流れで作られます。ChatGPTのような生成AIは、膨大な文章で「次の言葉の予測」を学ぶ事前学習のあと、人が作った対話例や人の評価を使った追加の学習で調整されています。
AIはプログラムで動いているのですか?
はい。機械学習では、人がデータの扱い方や学習の手順を設計し、予測に使うパラメータや分岐条件などをデータから調整します。通常のルール処理と学習済みモデルを組み合わせたシステムもあります。
ChatGPTは考えて答えているのですか?
中心となる言語モデルは、文脈をもとに次のトークンを生成して文章を作ります。製品や設定によっては検索や計算なども組み合わせますが、自然な説明や長い推論があっても正しさが保証されるわけではありません。重要な判断に使う数値・引用・条件は元の情報源で確かめましょう。
初心者でもAIを作れますか?
この記事のコード例のような小さな機械学習モデルなら、Pythonとscikit-learnを使って初心者でも作れます。一方、ChatGPTのような大規模なモデルを一から作るには、膨大なデータと計算資源が必要です。個人や企業では、公開されている学習済みモデルやAIサービスを組み合わせてアプリを作る方法もよく使われます。
AIを学ぶのに数学は必要ですか?
文章作成など身近な用途では、高度な数学を先に学ばなくても始められます。出力の数値を判断するための基礎的な理解は役立ちます。仕組みを深く理解したりモデルを開発したりする場合は、微分、確率・統計、行列などを順に学ぶとよいでしょう。
質問するたびにAIの学習は進みますか?
学習済みモデルに入力して答えを得る推論は、通常、その処理だけでモデルの重みを書き換えません。会話の文脈を参照すること、サービスが履歴を保存すること、後日学習に利用することは分けて考えましょう。
モデルを保存すれば、Pythonなしでもそのまま使えますか?
この教材のmodel.jsonにはwとbの数値が入っています。その数値を読み、y = w * x + bを計算するプログラムが別に必要です。別の言語で同じ計算を実装することもできますが、ファイルを置いただけでは予測は動きません。
まとめ:学習でモデルを作り、推論で使う
AIの仕組みを理解する最初の一歩は、データからモデルを調整する「学習」と、学習済みモデルに入力して結果を得る「推論」を分けることです。機械学習はAIの方法の1つ、深層学習は機械学習の方法の1つで、生成AIは文章や画像を作る用途に注目した呼び方です。
まずは線形モデルとIrisの例を動かし、余裕があれば保存・推論の教材まで試してください。「どこで学習し、何を保存し、どのデータで確かめたか」を説明できると、AIを使うときにも結果を確かめる視点を持てます。
写真風表紙と水彩の概念図は説明用のAI生成素材です。新しい学習曲線は教材コードの実行データから作成しています。実在の授業風景や製品内部の画面を再現したものではありません。
英語でIT・AIを学べるKredo
英語×IT・AIのスキルを身につけてグローバルに活躍しませんか?
当メディアを運営しているKredoは、英語×ITをオンラインで学ぶ「Kredoオンラインキャンプ」と、フィリピンのセブ島で英語とIT・AIを学ぶ「KredoIT留学」「KredoAI留学」を提供しています。これまでの卒業生は3,000名以上。卒業生の多くが、国内外のIT企業への転職、フリーランスなどへのキャリアチェンジを実現しています。これからの時代に必要な英語×IT・AIのスキルを身につけてグローバルに活躍しませんか?